cyxCoder
明天你会感谢今天奋力拼搏的你。
ヾ(o◕∀◕)ノヾ
Java多线程高并发系列:(十一)并发容器
一、基本概念
在 Java 中,并发容器是为了在多线程环境下高效、安全地处理数据而设计的容器类,主要位于java.util.concurrent包中。它们通过更高效的并发控制机制(如CAS、分段锁、写时复制等)替代传统的同步方法(如synchronized),显著提升了高并发场景下的性能。这些容器类提供了线程安全的操作,避免了在多线程环境中使用传统容器(如 ArrayList、HashMap 等)时可能出现的并发问题。
常用的并发容器:
- ConcurrentHashMap:线程安全的哈希表。JDK1.7实现:分段锁;JDK1.8实现:元素(key)锁(Condition)+链表+红黑树
- SkipList:跳表自动随机维护一套索引,用于高效的索引List中的有序数据。
- ConcurrentSkipListMap:基于跳表实现的线程安全的有序映射。是TreeMap的并发实现。
- ConcurrentSkipListSet:是基于 ConcurrentSkipListMap 实现的线程安全的有序集合,是TreeSet的并发实现。
- ConcurrentLinkedQueue:是基于链表实现的无界线程安全队列,是LinkedList的并发实现。
- CopyOnWriteArrayList:是线程安全的动态数组。写时复制,在添加元素是,复制一个新的容器,在新容器中新增元素;读数据都在Old容器中操作,进行读写分离。数据一致性较弱,适合读多写少的场景。
- CopyOnWriteArraySet:是基于 CopyOnWriteArrayList 实现的线程安全的集合。
二、ConcurrentHashMap
实现原理:
- Java 7:分段锁(Segment),每个段独立加锁,不同段可并发操作。
- Java 8+:CAS + synchronized锁单个桶(Node),链表转红黑树优化查询。
适用场景:高频读写的键值存储(如缓存)。
2.1、JDK1.7下的实现
在 JDK 1.7 中,ConcurrentHashMap 采用分段锁(Segment)机制来实现并发操作,这种设计可以在保证线程安全的同时,提高并发性能。下面详细介绍其实现原理。
整体结构:一个ConcurrentHashMap里包含一个Segment数组。Segment的结构和HashMap类似,是一种数组和链表结构,它们都继承自 ReentrantLock,可以独立进行加锁操作。不同的 Segment 之间可以并发访问,从而提高了并发性能。一个Segment里包含一个HashEntry数组,每个HashEntry是一个链表结构的元素,HashEntry用于存储键值对数据。每个Segment守护着一个HashEntry数组里的元素,当对HashEntry数组的数据进行修改时,必须首先获得与它对应的Segment锁。
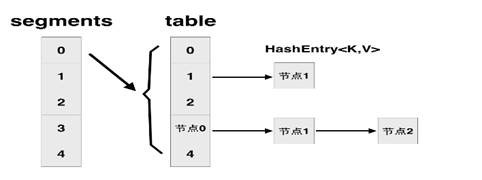
分段锁的这种结构,就意味着有多少个Segment就有多少并发。
初始化逻辑:在创建 ConcurrentHashMap 时,需要指定初始容量、加载因子和并发级别。并发级别决定了 Segment 的数量,默认值为 16。初始化过程会创建一个 Segment 数组,并初始化第一个 Segment,其他 Segment 会在需要时进行懒加载。
put方法逻辑:
- 首先,根据键的哈希码计算出对应的 Segment 索引。
- 然后,对该 Segment 进行加锁操作,确保同一时间只有一个线程可以对该 Segment 进行写操作。
- 接着,在该 Segment 内部的 HashEntry 数组中查找键是否已经存在,如果存在则更新其值;如果不存在,则创建一个新的 HashEntry 并插入到链表头部。
- 最后,释放锁。
get方法逻辑:
- 首先,根据键的哈希码计算出对应的 Segment 索引。
- 然后,在该 Segment 内部的 HashEntry 数组中查找键对应的 HashEntry。由于 HashEntry 中的值使用 volatile 关键字修饰,因此可以保证在多线程环境下的可见性,不需要加锁操作。
- 如果找到则返回其值,否则返回 null。
扩容操作逻辑:当某个 Segment 内部的元素数量超过阈值(容量 * 加载因子)时,该 Segment 会进行扩容操作。扩容过程会创建一个新的 HashEntry 数组,其容量为原来的 2 倍,然后将原数组中的所有 HashEntry 重新哈希到新数组中。
优缺点:
- 优点:通过分段锁机制,不同的 Segment 可以并发进行读写操作,大大提高了并发性能。在多线程环境下,多个线程可以同时访问不同的 Segment,从而减少了锁的竞争。
- 缺点:由于每个 Segment 都需要维护自己的锁和数据结构,会占用更多的内存空间。而且,在某些情况下,例如需要对整个 ConcurrentHashMap 进行全局操作(如 size() 方法)时,需要对所有的 Segment 进行加锁,性能会受到一定影响。
2.2、JDK1.8下的实现
在 JDK 1.8 中,ConcurrentHashMap 的实现有了较大的改进,摒弃了 JDK 1.7 中的分段锁(Segment)机制,采用了 CAS(Compare-And-Swap)和 synchronized 来保证并发操作的线程安全性,并且在数据结构上引入了红黑树以提高查找效率。
整体结构:JDK 1.8 的 ConcurrentHashMap 采用数组 + 链表 + 红黑树的结构。数组中的每个元素称为一个桶(bucket),当一个桶中存储的元素较少时,采用链表来存储这些元素;当链表长度超过一定阈值(默认为 8)且数组长度达到 64 时,链表会转换为红黑树,以提高查找效率;当红黑树中的元素数量减少到一定阈值(默认为 6)时,红黑树会转换回链表。
核心组件:
- Node:是 ConcurrentHashMap 存储键值对的基本单元,实现了 Map.Entry 接口。每个 Node 包含一个键、一个值、一个哈希码和一个指向下一个 Node 的引用,用于处理哈希冲突(采用链表法)。Node 的值使用 volatile 关键字修饰,保证了多线程环境下的可见性。
- TreeNode:继承自 Node,是红黑树的节点类。当链表转换为红黑树时,链表中的 Node 会被替换为 TreeNode。
- TreeBin:封装了 TreeNode,是红黑树的根节点。TreeBin 不存储键值对,而是负责管理红黑树的操作,如插入、删除、查找等。
初始化逻辑:在创建 ConcurrentHashMap 时,并不会立即初始化数组,而是在第一次插入元素时进行懒加载。初始化过程会创建一个指定大小的数组,默认初始容量为 16。
put方法逻辑:
- 计算哈希值:根据键的 hashCode() 方法计算哈希值。
- 判断数组是否初始化:如果数组未初始化,则进行初始化操作。
- 计算桶的索引:根据哈希值计算元素应该插入的桶的索引。
- 判断桶是否为空:如果桶为空,则使用 CAS 操作将新节点插入到该桶中;如果 CAS 操作失败,则说明有其他线程已经插入了元素,需要重新进行操作。
- 判断桶是否被锁住:如果桶不为空且该桶的头节点的哈希值为 MOVED(表示该桶正在进行扩容操作),则当前线程需要帮助进行扩容操作;否则,使用 synchronized 关键字对该桶的头节点进行加锁,然后遍历链表或红黑树,查找是否存在相同的键,如果存在则更新其值,否则插入新节点。
- 判断是否需要转换为红黑树:如果链表长度超过阈值(默认为 8)且数组长度达到 64,则将链表转换为红黑树。
- 释放锁:插入操作完成后,释放锁。
get方法逻辑:
- 计算哈希值:根据键的 hashCode() 方法计算哈希值。
- 计算桶的索引:根据哈希值计算元素所在的桶的索引。
- 查找元素:如果桶为空,则直接返回 null;如果桶的头节点的哈希值为 MOVED(表示该桶正在进行扩容操作),则当前线程需要帮助进行扩容操作;否则,遍历链表或红黑树,查找是否存在相同的键,如果存在则返回其值,否则返回 null。由于 Node 的值使用 volatile 关键字修饰,因此可以保证在多线程环境下的可见性,不需要加锁操作
扩容操作逻辑:当数组中的元素数量超过阈值(容量 * 加载因子)时,ConcurrentHashMap 会进行扩容操作。扩容过程会创建一个新的数组,其容量为原来的 2 倍,然后将原数组中的所有元素重新哈希到新数组中。为了提高扩容效率,采用了多线程并发扩容的方式,多个线程可以同时帮助进行扩容操作。
优点:
- 更高的并发性能:摒弃了分段锁机制,采用 CAS 和 synchronized 进行同步,减少了锁的粒度,提高了并发性能。
- 内存占用减少:不再需要维护多个 Segment,减少了内存的占用。
- 引入红黑树:在链表长度过长时,将链表转换为红黑树,提高了查找效率,时间复杂度从 O(n)降低到 O(logn)。
三、ConcurrentSkipListMap和ConcurrentSkipListSet
ConcurrentSkipListMap 和 ConcurrentSkipListSet 是 Java 并发包 java.util.concurrent 中提供的两个线程安全的数据结构,它们都基于跳表(Skip List)数据结构实现。
- ConcurrentSkipListMap:可以理解为是TreeMap的并发实现,它实现了 ConcurrentNavigableMap 接口,键是按照自然顺序或者指定的比较器顺序进行排序的。与 TreeMap 不同,ConcurrentSkipListMap 是线程安全的。
- ConcurrentSkipListSet:可以理解为是TreeSet的并发实现,它实现了 NavigableSet 接口,元素是按照自然顺序或者指定的比较器顺序进行排序的。ConcurrentSkipListSet 实际上是基于 ConcurrentSkipListMap 实现的,它将元素作为键存储在 ConcurrentSkipListMap 中,值则统一使用一个静态的 Object 对象。
3.1、跳表(SkipList)
跳表是在有序链表的基础上发展而来的。普通的有序链表在进行查找操作时,需要从头节点开始逐个遍历,时间复杂度为 (O(n))。为了提高查找效率,跳表通过在原始链表的基础上增加多层索引,使得在查找元素时可以跳过一些不必要的节点,从而加快查找速度。

传统意义的单链表是一个线性结构,向有序的链表中插入一个节点需要O(n)的时间,查找操作需要O(n)的时间。如果我们使用上图所示的跳跃表,就可以减少查找所需时间为O(n/2),因为我们可以先通过每个节点的最上面的指针先进行查找,这样子就能跳过一半的节点。
比如我们想查找19,首先和6比较,大于6之后,在和9进行比较,然后在和12进行比较......最后比较到21的时候,发现21大于19,说明查找的点在17和21之间,从这个过程中,我们可以看出,查找的时候跳过了3、7、12等点,因此查找的复杂度为O(n/2)。
跳跃表其实也是一种通过“空间来换取时间”的一个算法,通过在每个节点中增加了向前的指针,从而提升查找的效率。
四、List、Set、Queue的并发容器
Java对List、Set、Queue也提供了一系列的并发容器:
- List的线程安全实现:Vector、CopyOnWriteArrayList
- Set线程安全的实现:CopyOnWriteArraySet
- Queue线程安全实现:ConcurrentLinkedQueue(高性能非阻塞队列)、BlockingQueue(阻塞队列)类族下的实现,基本都通过可重入锁实现了线程安全。
4.1、CopyOnWriteArrayList
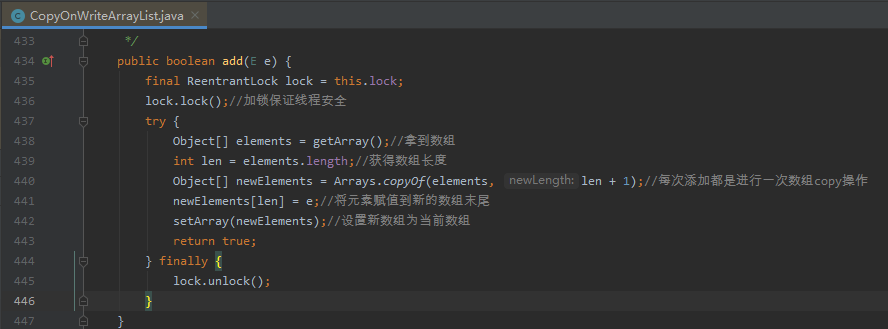
CopyOnWriteArrayList 是ArrayList的并发实现,它通过在每次修改操作(如 add、remove 等)时创建底层数组的一个新副本,然后在新数组上进行修改操作,最后将新数组替换原来的数组,从而实现线程安全。读操作则直接在原数组上进行,不需要加锁。因此在多线程环境下,读操作可以并发执行,性能较高。
优点:
- 读操作不需要加锁,并发性能高,适合读多写少的场景。
- 线程安全,在多线程环境下可以直接使用,无需额外的同步机制。
缺点:
- 写操作需要复制数组,内存开销较大,不适合频繁写操作的场景。
- 由于写操作会创建新数组,可能会导致迭代器看到的是旧数据,即存在弱一致性问题(数据写完之后,其他线程不一定是马上读取到最新内容,即脏读的存在)。
Vector的比较:
- Vector是Java早期提供的线程安全容器,通过在方法层面加上synchronized关键字实现的线程安全。这种粗粒度的同步机制会带来较大的性能开销,其读写都会被加锁,降低了系统的并发处理能力。
- 因此更优的替代方案是通过CopyOnWriteArrayList、ConcurrentSkipListList实现。
与ArrayList比较:
- 如果用读写锁对ArrayList进行操作,会有一个问题,获取写锁的时候会阻塞大量读操作。
场景:适用于读极多写极少的场景,比如:白名单、黑名单、商品类目的访问和更新等。如果对数据版本及其严格,要实时读到数据,就不能用此类,还是得用读写锁。
注意:从下面的代码可以看出,每次添加删除都是对数组的拷贝,这样消耗性能很多,只能适用于读极多写极少的场景,且如果数据量很大也不能用,因为是通过copy进行的,copy的时候内存容量*2。
4.2、CopyOnWriteArraySet
CopyOnWriteArraySet内部使用 CopyOnWriteArrayList 来存储元素,利用 CopyOnWriteArrayList 的写时复制机制来保证线程安全。所以很多特性可以之间参考上文的CopyOnWriteArrayList。
- 优点:与 CopyOnWriteArrayList 类似,读操作不需要加锁,并发性能高,适合读多写少的场景。
- 缺点:写操作需要复制数组,会消耗较多的内存和时间,不适合写操作频繁的场景。
4.3、ConcurrentLinkedQueue
ConcurrentLinkedQueue 位于 java.util.concurrent 包下,是一个使用链表结构实现的无界线程安全队列。可以理解为是LinkedList的并发版本,在多线程环境下,多个线程可以同时对该队列进行读写操作,而不需要额外的同步机制,其内部通过使用 CAS(Compare-And-Swap)操作来保证线程安全。
特点
- 线程安全:ConcurrentLinkedQueue 是线程安全的,多个线程可以同时对队列进行入队和出队操作,而不需要额外的同步措施。
- 无界队列:它是一个无界队列,队列的容量可以随着元素的添加而动态增长,因此不会出现队列满的情况。
- 基于链表实现:使用链表结构存储元素,插入和删除操作的时间复杂度为 O (1)。
- 非阻塞操作:入队和出队操作都是非阻塞的,不会因为队列满或空而阻塞线程。
缺点:并发极高的情况下可能导致自旋很多次(成百上千)影响性能。
扩展:用锁可以解决自旋的问题,但是也不能解决高并发的问题。高并发情况下要考虑用其他方式进行限流。
4.4、BlockingQueue及其实现类
BlockingQueue 是一个阻塞队列接口,在 Java 中,阻塞队列(BlockingQueue)接口的实现类都是线程安全的,它提供了阻塞式的插入和移除操作。当队列满时,插入操作会阻塞;当队列空时,移除操作会阻塞。
| 类名 | 描述 | 数据结构 | 线程安全实现方式 | 适用场景 |
|---|---|---|---|---|
ArrayBlockingQueue |
有界阻塞队列,创建时需指定容量,按 FIFO(先进先出)原则对元素排序。 | 数组 | 使用一个 ReentrantLock 以及两个 Condition 对象(分别用于控制插入和移除的等待)来保证线程安全。当队列满时,插入线程会被阻塞;当队列空时,移除线程会被阻塞。 |
适用于需要固定大小缓冲区的生产者 - 消费者场景,例如限制资源使用量的情况,像固定数量的任务处理池。 |
LinkedBlockingQueue |
可选有界的阻塞队列,默认最大容量为 Integer.MAX_VALUE,按 FIFO 原则对元素排序。 |
链表 | 使用两个 ReentrantLock(一个用于入队,一个用于出队)和相应的 Condition 对象,允许入队和出队操作并发执行,提高了并发性能。 |
适用于生产者和消费者速度差异较大的场景,因其可以有较大容量来缓冲数据,如 Web 服务器中请求的处理。 |
PriorityBlockingQueue |
无界阻塞队列,元素根据自然顺序或指定的比较器进行排序。 | 优先级堆 | 使用 ReentrantLock 和 Condition 来保证线程安全,插入元素时会根据优先级调整堆结构。 |
适用于需要根据元素优先级进行处理的场景,如任务调度系统,高优先级任务可以优先被处理。 |
DelayQueue |
无界阻塞队列,用于存放实现了 Delayed 接口的元素,只有在元素的延迟时间到期后才能被取出。 |
优先级堆(根据延迟时间排序) | 使用 ReentrantLock 和 Condition 保证线程安全,在取出元素时会检查延迟时间是否到期。 |
适用于实现定时任务调度,如缓存过期清理、任务超时处理等场景。 |
SynchronousQueue |
没有容量的阻塞队列,每个插入操作必须等待另一个线程的移除操作,反之亦然。 | 基于内部的交换机制(没有实际存储元素的数据结构) | 通过内部的状态管理和锁机制保证线程安全,确保插入和移除操作的同步。 | 适用于生产者和消费者紧密协作的场景,一个生产操作必须立即被消费操作处理,常用于线程池中的任务传递。 |
LinkedTransferQueue |
无界阻塞队列,支持 transfer 方法,可直接将元素传递给等待的消费者。 |
链表 | 使用 CAS(Compare - And - Swap)操作和内部锁机制保证线程安全,高效地处理元素的插入和移除。 | 适用于高并发场景下的生产者 - 消费者模式,特别是需要快速传递元素的场景。 |
LinkedBlockingDeque |
可选有界的双向阻塞队列,默认最大容量为 Integer.MAX_VALUE,支持从队列两端进行插入和移除操作。 |
双向链表 | 使用 ReentrantLock 和 Condition 保证线程安全,允许从队列的头部和尾部进行并发操作。 |
适用于需要双向操作队列的场景,如工作窃取算法中的任务队列,工作线程可以从队列头部或尾部获取任务。 |
全部评论